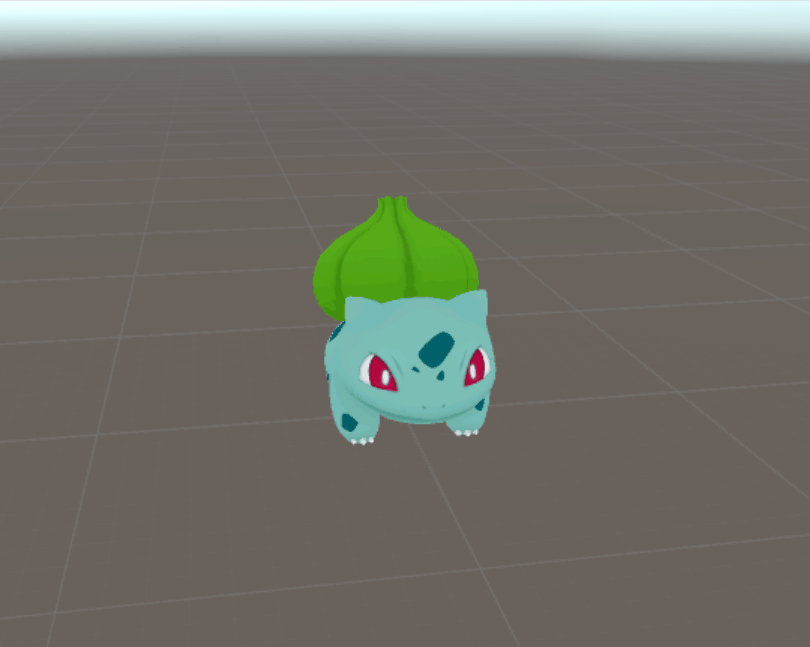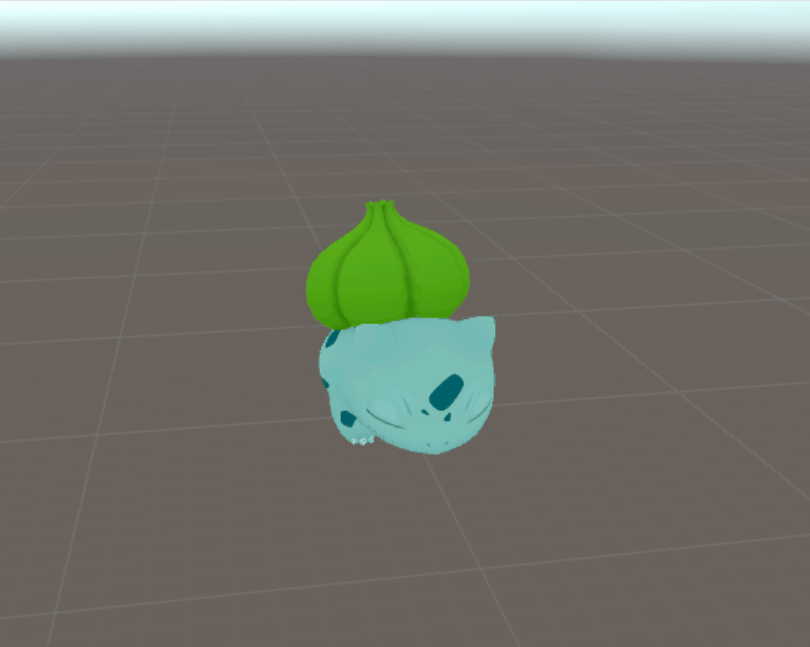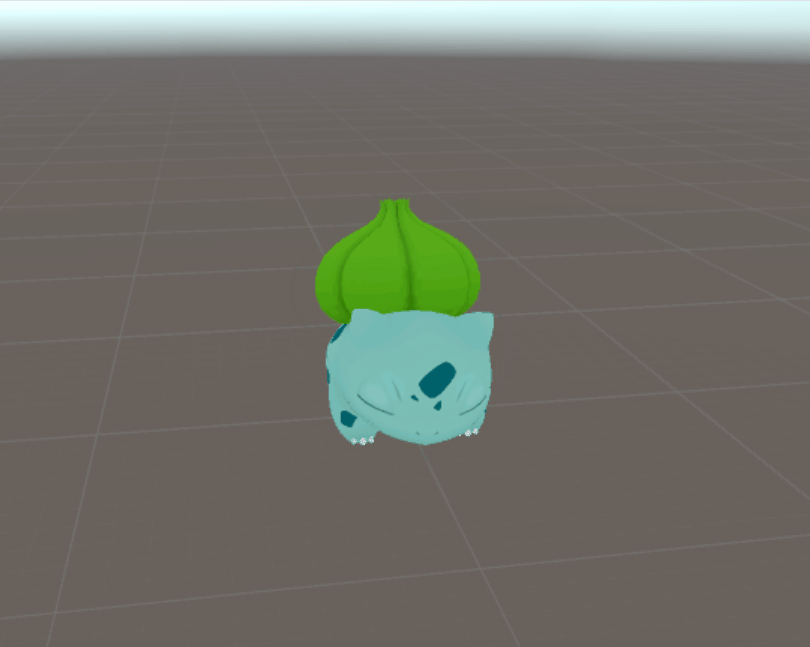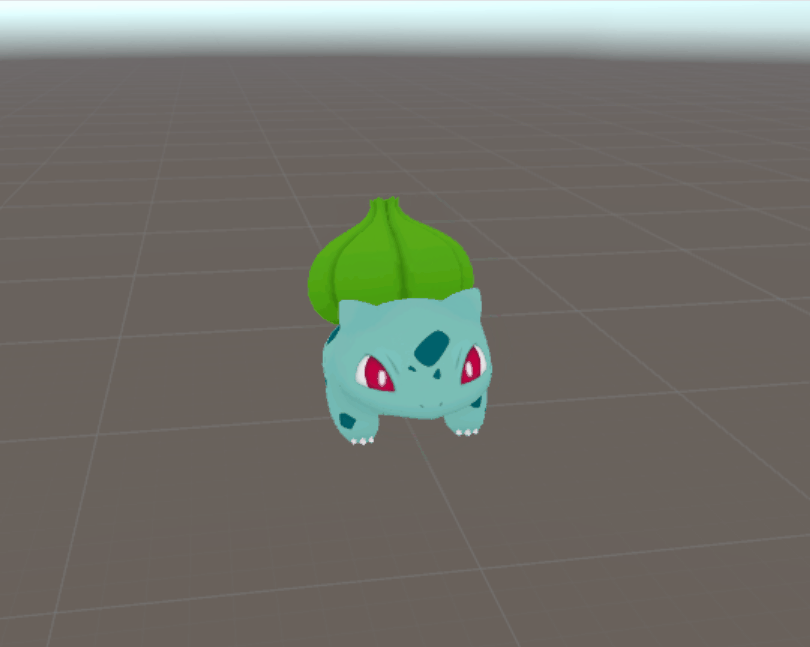


Buenas, os dejo por aquí un write up de ingeniería inversa de modelos y animaciones de Pokémon 3D Pro para 3DS. Mencionar que sus archivos en formato .z5 nunca han sido descritos y que la única herramienta hecha por Ploaj, no está disponible previamente a este post. Bien, como es habitual, se ha realizado la investigación de este juego de Nintendo 3DS mediante un importador de modelos para Unity Engine, por lo que se hablará del importer haciendo referencia a él. Se ha utilizado la ROM europea con el Romfs volcado desde Citra 3DS. Importante que los offsets mostrados hacen referencia a los archivos decodificados y no offsets en ROM como en otros write-ups publicados en este foro.
¡Vamos al lío!
1. Estructura general
El pipeline de los modelos 3D de Pokémon de Pokédex 3D Pro (Nintendo 3DS) se basa en un sistema de recursos binarios que separa la información geométrica, las texturas, los materiales, la jerarquía de huesos y las animaciones. Estos datos deben interpretarse y relacionarse entre sí para reconstruir correctamente cada Pokémon fuera del motor original del juego. Los modelos 3D están contenidos en una serie de archivos con formato .z5 dentro de Romfs/Pokemon y se cargan dinámicamente en el juego.
2. Flujo de datos
El modelo 3D no se obtiene leyendo directamente una malla desde el archivo original. El pipeline consta de dos etapas: primero se recupera el bloque binario del modelo, descomprimiéndolo cuando corresponde, y después se interpretan sus tablas para relacionar texturas, materiales, buffers geométricos y mallas. El esqueleto y las animaciones se procesan mediante sus propios registros y se incorporan al resultado final.
2.1. Identificación y decodificación
El primer paso consiste en reconocer el contenedor Z5 y distinguir la variante que contiene datos comprimidos. Cuando existe un stream LZH8, éste debe descomprimirse antes de interpretar las tablas del modelo. La firma 0x000078C5 corresponde al bloque ya decodificado, no debe confundirse con la identificación del contenedor externo.
Una vez obtenido el bloque decodificado, todos los accesos deben validarse contra su longitud real. La geometría no puede reconstruirse de forma fiable hasta resolver las regiones de metadatos y bulk, porque los descriptores no contienen necesariamente los datos a los que hacen referencia.
2.2. Resolución de referencias
Las tablas utilizan dos mecanismos distintos: índices para relacionar registros (por ejemplo, una malla con su vertex buffer, index buffer y material) y offsets para localizar datos binarios. No deben mezclarse las bases de direccionamiento: los offsets de tablas pertenecen al bloque decodificado, mientras que los offsets de los datos de vértices, índices y texturas se interpretan respecto al comienzo de bulk.
Estas fórmulas describen las bases de direccionamiento usadas en la estructura documentada. Antes de leer cualquier registro se comprueba que su intervalo completo queda dentro de la región correspondiente.
3. Cabecera del modelo decodificado
El bloque decodificado comienza con una cabecera fija de 120 bytes (0x78). Esta cabecera indica cuánto espacio ocupan los metadatos y el bulk, además de proporcionar los recuentos y offsets de las tablas. Los enteros se presentan aquí con los tipos utilizados por el parser; no se atribuye significado adicional a los campos que todavía no se han identificado.
3.1. Delimitación de las regiones
La longitud del archivo decodificado debe coincidir exactamente con la suma de las tres regiones. Esta igualdad es una comprobación estructural fundamental: evita aceptar datos truncados o interpretar bytes de una sección como si pertenecieran a otra.
3.2. Tabla de cadenas
La tabla de cadenas empieza en offsets[14] y su longitud se obtiene de counts[14]. Según la invariante indicada por el parser, esta tabla termina exactamente donde comienza bulk.
La tabla permite resolver los nombres utilizados por otros registros. Un offset de nombre debe validarse contra el intervalo de cadenas antes de acceder a él; no debe tratarse como un puntero a una cadena arbitraria del archivo.
3.3. Recuentos y offsets
counts contiene 16 entradas de 16 bits, mientras que offsets contiene 19 entradas de 32 bits. No todas las entradas representan necesariamente tablas de registros del mismo tipo. El parser debe utilizar el stride específico de cada tabla conocida y comprobar que count * stride cabe en el intervalo de metadatos permitido. Las entradas sin semántica demostrada no deben recibir nombres inventados.
4. Tablas de metadatos
Tras la cabecera se encuentran los descriptores que organizan los recursos del modelo. Cada tabla tiene un recuento y, cuando su formato está identificado, un tamaño fijo por registro (stride). Estos registros sirven para localizar los datos reales o enlazar unos elementos con otros.
4.1. Lectura de una tabla
Para una tabla de stride conocido, el registro N se localiza a partir de su offset de tabla y su índice. El tamaño total ocupado se calcula multiplicando el número de registros por su stride.
La validación debe comprobar tanto el intervalo total de la tabla como el registro individual. Es importante realizar las sumas y multiplicaciones sin desbordamientos antes de construir las direcciones finales.
4.2. Relación entre las tablas principales
Los descriptores de textura identifican recursos de imagen; los materiales determinan su uso en el render; los vertex buffers contienen atributos de vértice; los index buffers definen qué vértices forman cada triángulo; y los registros de malla vinculan estas piezas por índice. Por ello, el orden correcto es interpretar primero las tablas de recursos y después construir cada malla a partir de sus referencias.
4.3. Tablas todavía no identificadas
Las tablas auxiliares se conservan como datos crudos cuando su estructura o finalidad no está suficientemente demostrada. En particular, no debe asumirse que las tablas 7 y 8 de este bloque son equivalentes a cualquier tabla de tracks o secuencias usada en otro decodificador sin comprobar su contexto.
Nota: Las tablas con semántica incompleta se conservan como datos crudos. No debe atribuirse un significado no demostrado a sus campos.
5. Vertex buffers
Los vertex buffers almacenan los atributos de los vértices en la región bulk. Sus descriptores están en la tabla 4 y tienen un tamaño fijo de 0x14 bytes. Cada descriptor indica dónde comienza el bloque, cuántos vértices contiene, cuánto ocupa cada vértice y qué distribución de atributos utiliza.
5.1. Layouts reconocidos
El parser no admite una única estructura universal de vértice. El stride debe corresponder al identificador de layout esperado; esta pareja es la que determina cómo interpretar los bytes del registro.
No se debe interpretar un registro de 20 bytes como si tuviera los mismos atributos y offsets que uno de 40. El identificador de layout es parte de la validación del formato, no un campo decorativo.
5.2. Direccionamiento y lectura
Una vez elegido el layout, los vértices se leen secuencialmente a partir de bulk + dataOffset. El tamaño total del buffer es count * stride.
Se debe verificar que el intervalo completo cabe en bulk antes de leer cualquier atributo. Esto también permite detectar referencias a buffers incompletos o offsets fuera de la región binaria.
5.3. Coordenadas UV
La posición del atributo UV depende del tamaño del registro. Para el layout de 40 bytes, el offset es +0x18; para los otros layouts admitidos, es +0x0C.
La lectura del resto de atributos debe seguir el layout correspondiente. No conviene extrapolar una disposición de normales, colores o pesos de skinning sin verificarla en el parser y en los datos originales.
6. Index buffers y triángulos
Los index buffers definen la conectividad de la geometría: en lugar de repetir las coordenadas de cada vértice por triángulo, almacenan índices que apuntan a las entradas de un vertex buffer. Sus descriptores pertenecen a la tabla 5 y ocupan 0x0C bytes.
6.1. Lectura de índices
Los índices se almacenan en bulk, a partir de dataOffset. El valor 2 del campo indexSize indica que cada índice ocupa dos bytes. Por tanto, el tamaño del bloque es indexCount * 2.
El intervalo calculado debe quedar completamente dentro de bulk. Además, cada índice debe ser menor que el número de vértices del vertex buffer que utiliza la malla.
6.2. Formación de triángulos
La estructura documentada representa triángulos mediante grupos consecutivos de tres índices. Por eso indexCount debe ser múltiplo de tres.
El orden de los índices determina el winding de cada cara. Cualquier adaptación del orden de vértices o del sistema de coordenadas para Unity debe hacerse de forma consistente con las normales y el culling; no se debe modificar arbitrariamente el orden original durante el parseo.
7. Meshes
La tabla 6 contiene los registros de malla. Cada registro ocupa 0x28 bytes y relaciona un material, un vertex buffer y un index buffer. Esto significa que la malla no necesita incluir los vértices y triángulos dentro de su propio descriptor: utiliza referencias a los recursos ya descritos en otras tablas.
7.1. Resolución de recursos
El primer paso para reconstruir una malla consiste en resolver sus tres referencias: materialIndex apunta a la tabla 2, vertexBufferIndex a la tabla 4 e indexBufferIndex a la tabla 5. Cada índice debe estar dentro del recuento de su tabla.
Después se lee el vertex buffer con su layout, se recuperan los índices y se comprueba que todos los triángulos hacen referencia a vértices válidos.
7.2. Comprobación del número de triángulos
El registro de malla incluye triangleCount, que debe coincidir con el número de triángulos obtenido del index buffer asociado. Esta comprobación detecta referencias equivocadas o una lectura incorrecta de los descriptores.
7.3. Bounding box
Los seis floats situados entre +0x10 y +0x24 representan los límites mínimo y máximo de la malla en los ejes X, Y y Z. Sirven como referencia espacial para validar la geometría reconstruida y describir la extensión del objeto.
Si el importer aplica una conversión de ejes o de unidades, los bounds deben transformarse de forma coherente con los vértices. No es correcto reutilizar directamente unos límites del sistema original si la geometría se ha convertido a otro sistema de coordenadas.
7.4. Construcción final
Una vez resueltas las referencias, el exportador puede construir el objeto Mesh de Unity: carga los atributos de los vértices, asigna los índices de triángulos, aplica el material correspondiente y lo incorpora a la jerarquía del modelo. El esqueleto y los clips se añaden mediante su pipeline independiente.
De esta manera, el formato mantiene separados los datos de geometría y los registros que los organizan, mientras que el importer recompone las referencias necesarias para obtener cada malla utilizable en Unity.
8. Esqueleto y animación
El sistema de animaciones de Pokémon Pokédex 3D Pro utiliza una representación basada en tracks independientes asociados a los nodos del esqueleto. En lugar de almacenar una transformación completa para cada hueso en todos los frames, cada track contiene una secuencia de keyframes con sus respectivos tiempos y valores. Durante la reproducción, el motor interpola estos valores para reconstruir las transformaciones intermedias.
La información de animación se encuentra separada de los buffers geométricos. El parser utiliza la tabla 7 para localizar los tracks y la tabla 8 para identificar las secuencias de animación.
8.1. Descriptores de tracks
Cada descriptor de track ocupa 0x10 bytes y contiene:
El campo channel determina cómo deben interpretarse los valores. Actualmente se reconocen tres combinaciones:
El parser verifica que targetIndex corresponda a un hueso existente y que su nombre coincida con el indicado por targetName. Los canales no reconocidos se contabilizan como tracks no soportados.
8.2. Formato de los keyframes
Los keyframes utilizan dos estructuras diferentes dependiendo del canal.
Para rotaciones, cada registro ocupa 0x0A bytes:
Los componentes del cuaternión se almacenan cuantizados en enteros de 16 bits. El decodificador los transforma a valores flotantes mediante:
Después calcula la longitud del cuaternión, comprueba que se encuentre entre 0.9 y 1.1 y lo normaliza. Esto permite recuperar una rotación válida a partir de los valores compactados.
Para traslación y escala, cada registro ocupa 0x10 bytes:
Los tiempos de las keys deben estar ordenados de forma estrictamente creciente y no superar lastFrame.
8.3. Reconstrucción de los frames
Una vez decodificadas las keys, el sistema puede calcular la transformación de cualquier frame de la animación. Primero se localizan las dos keys que rodean el frame solicitado. Para ello se utiliza una búsqueda binaria sobre los tiempos almacenados.
El factor de interpolación se calcula como:
Para traslaciones y escalas se aplica una interpolación lineal entre los valores de ambas keys:
Las rotaciones utilizan también una interpolación lineal de sus cuatro componentes, seguida de una normalización del cuaternión. Antes de interpolar, se comprueba el producto escalar entre ambos cuaterniones. Si es negativo, se invierte el signo del segundo para evitar cambios de orientación innecesarios. Cuando el frame solicitado queda fuera del intervalo de keys, se conserva el valor de la primera o última key correspondiente.
8.4. Secuencias de animación
La tabla 8 contiene las secuencias que agrupan los frames en animaciones individuales. Cada descriptor ocupa 0x0C bytes:
El número de frames de una secuencia se calcula como:
Cada secuencia selecciona un intervalo de la línea temporal global. Para reconstruirla se muestrean los tracks en los frames comprendidos entre firstFrame y lastFrame, ambos incluidos.
8.5. Conversión a Unity
El exportador reconstruye las animaciones a 60 FPS. Para cada secuencia genera curvas independientes de posición, rotación o escala y las asigna al Transform correspondiente mediante la ruta jerárquica del hueso. El tiempo de cada key exportada se calcula como:
Durante la generación se vuelve a comprobar la continuidad de los cuaterniones entre frames consecutivos. También se calculan las tangentes de las curvas y se eliminan determinadas keys intermedias redundantes para reducir el tamaño de los clips.
El resultado es una colección de AnimationClips que reproducen las transformaciones del esqueleto a partir de los datos originales del juego, sin necesidad de almacenar manualmente una pose completa para cada frame en el formato nativo. Con este procedimiento podemos reconstruir las secuencias óseas reconocidas por el parser. Quedan fuera de esta descripción los canales todavía no identificados y cualquier comportamiento adicional de animación que no esté representado en los tracks soportados.
9. Resultados
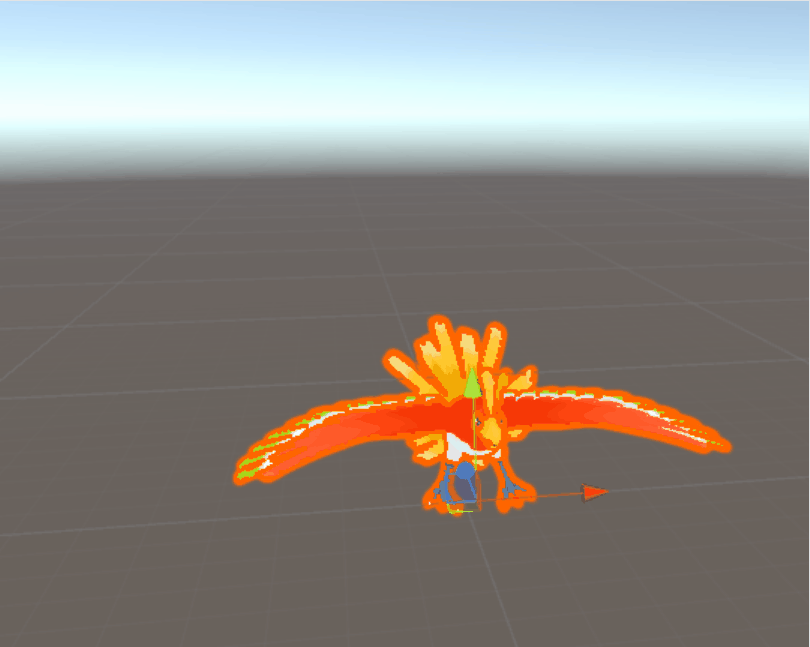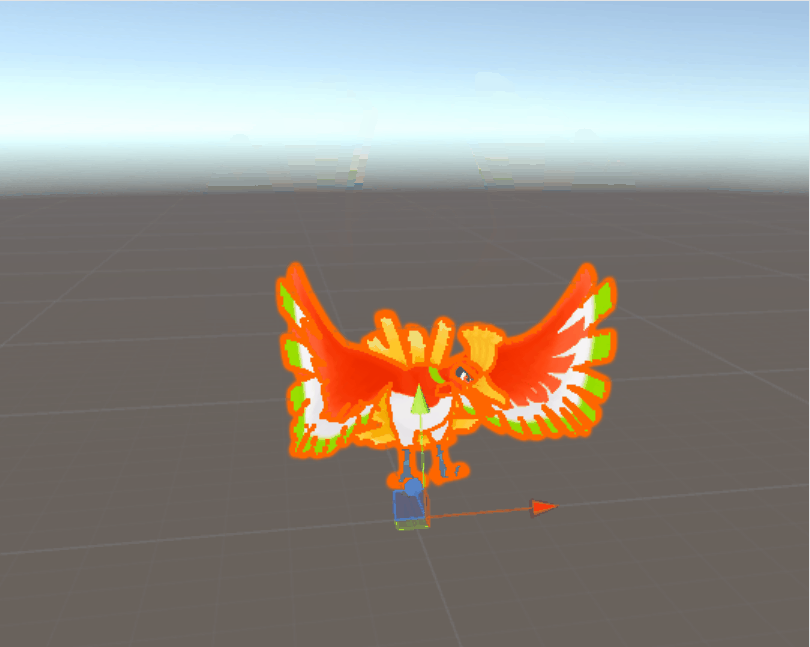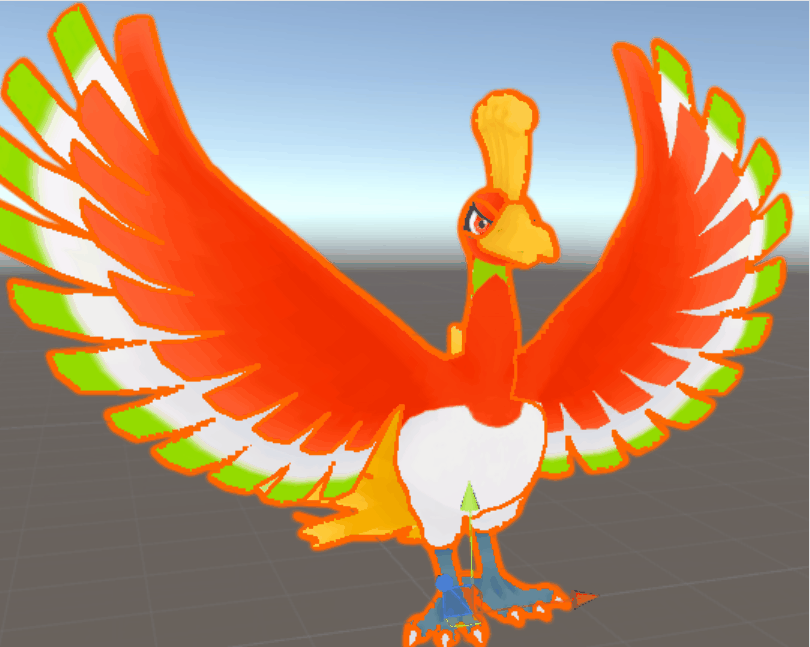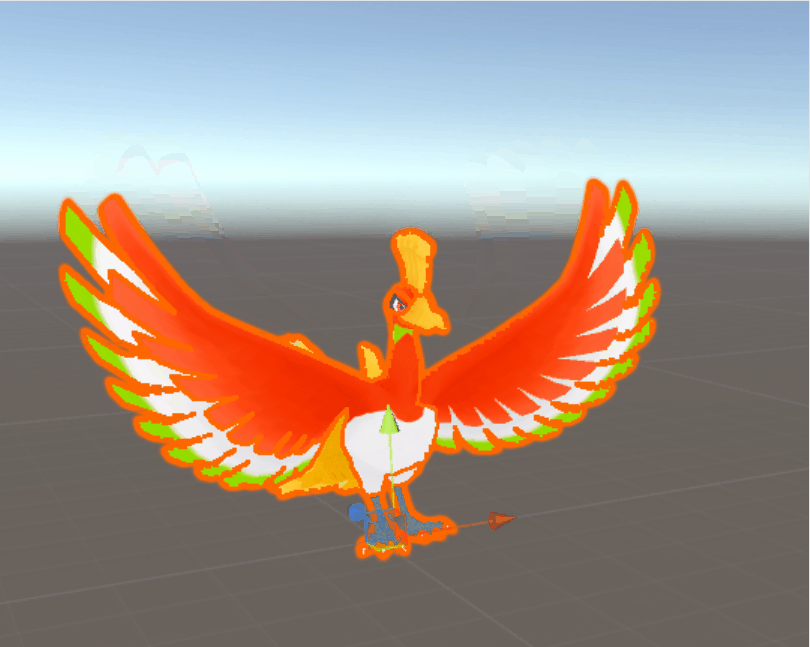
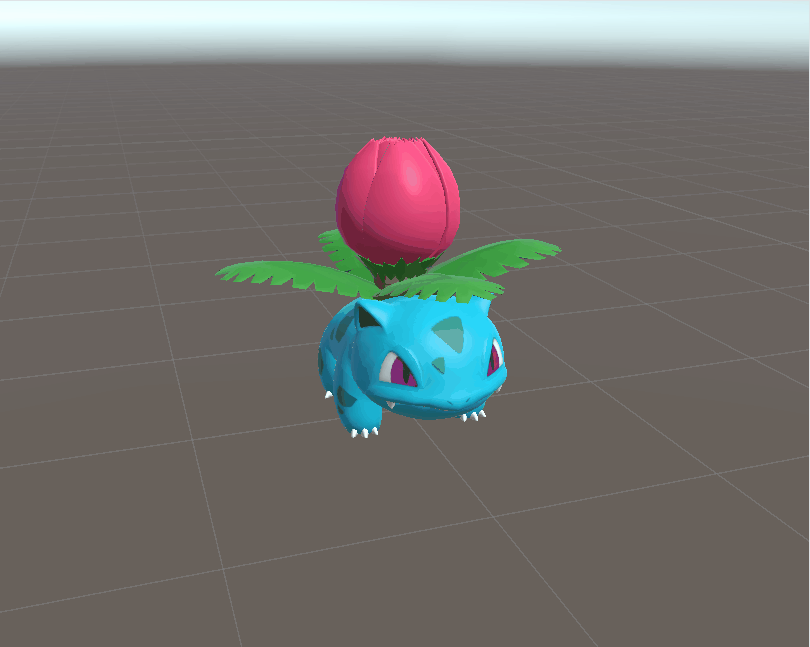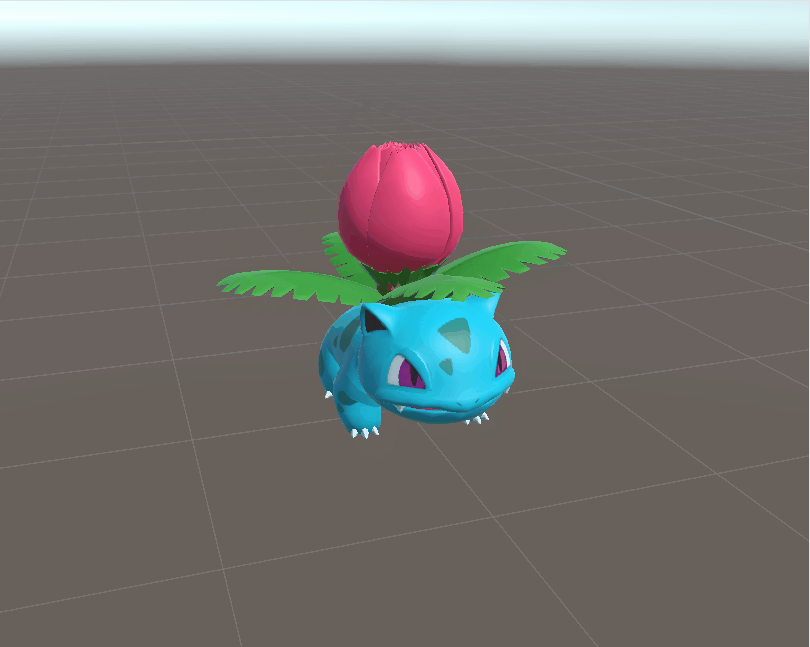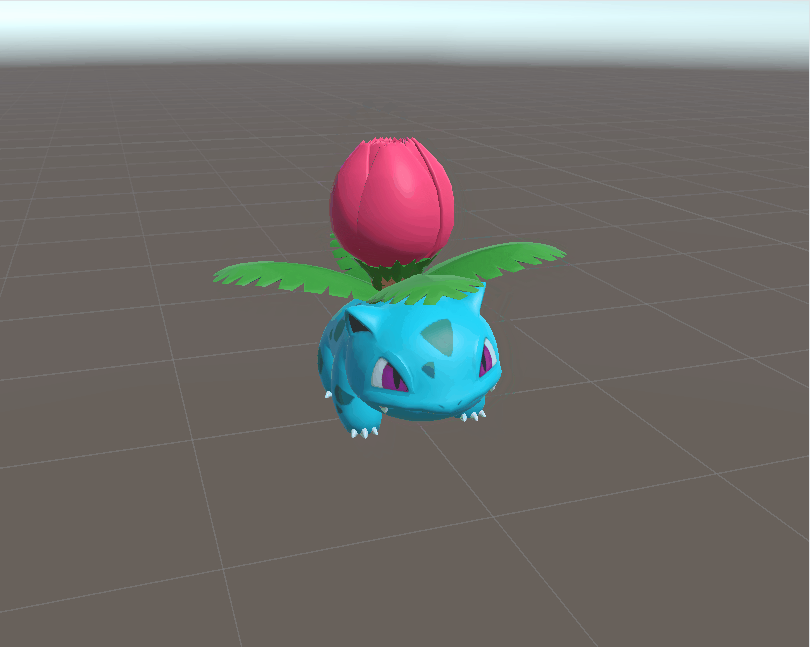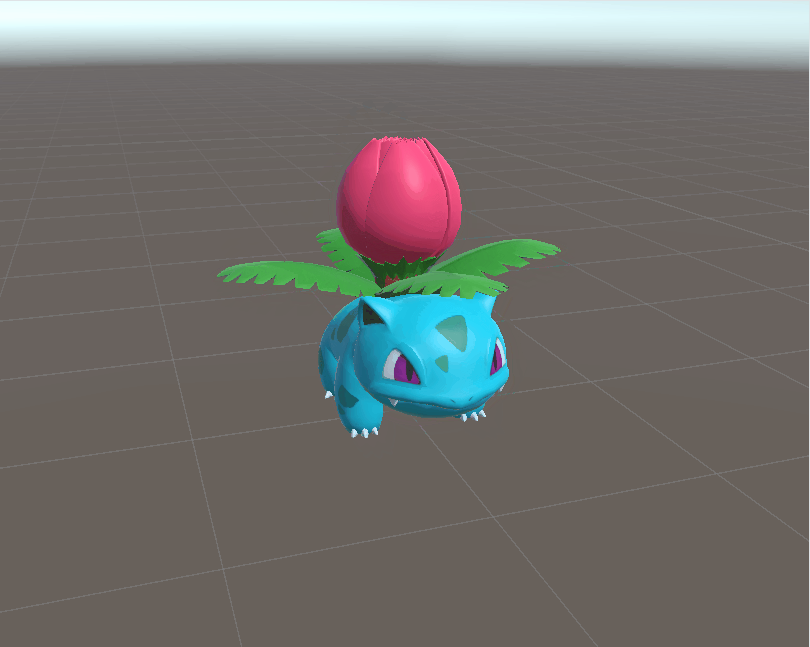
Como una imagen vale más que mil palabras, aquí está el resultado de toda esta investigación:
10. Front-end
Al utilizar Unity Engine como Front-End para hacer ingeniería inversa, obtenemos una forma directa y completamente user-friendly de importar modelos para Fangames.
¡Vamos al lío!
1. Estructura general
El pipeline de los modelos 3D de Pokémon de Pokédex 3D Pro (Nintendo 3DS) se basa en un sistema de recursos binarios que separa la información geométrica, las texturas, los materiales, la jerarquía de huesos y las animaciones. Estos datos deben interpretarse y relacionarse entre sí para reconstruir correctamente cada Pokémon fuera del motor original del juego. Los modelos 3D están contenidos en una serie de archivos con formato .z5 dentro de Romfs/Pokemon y se cargan dinámicamente en el juego.
2. Flujo de datos
El modelo 3D no se obtiene leyendo directamente una malla desde el archivo original. El pipeline consta de dos etapas: primero se recupera el bloque binario del modelo, descomprimiéndolo cuando corresponde, y después se interpretan sus tablas para relacionar texturas, materiales, buffers geométricos y mallas. El esqueleto y las animaciones se procesan mediante sus propios registros y se incorporan al resultado final.
Código:
Archivo de modelo Z5
  |
  +-- reconocer cabecera 0x01E5 / variante comprimida
  |      |
  |      +-- descomprimir stream LZH8, si corresponde
  |
  +-- bloque decodificado: magic 0x000078C5
         |
         +-- cabecera fija de 120 bytes
         +-- tablas de metadatos
         |      +-- texturas y materiales
         |      +-- vertex buffers e index buffers
         |      +-- mallas y referencias
         |      +-- otras tablas auxiliares
         +-- tabla de cadenas
         +-- bulk: datos binarios de los recursos
                |
                +-- resolver offsets y referencias
                +-- reconstruir geometría y materiales
                +-- asociar esqueleto y animaciones
+-- exportar assets de UnityEl primer paso consiste en reconocer el contenedor Z5 y distinguir la variante que contiene datos comprimidos. Cuando existe un stream LZH8, éste debe descomprimirse antes de interpretar las tablas del modelo. La firma 0x000078C5 corresponde al bloque ya decodificado, no debe confundirse con la identificación del contenedor externo.
Una vez obtenido el bloque decodificado, todos los accesos deben validarse contra su longitud real. La geometría no puede reconstruirse de forma fiable hasta resolver las regiones de metadatos y bulk, porque los descriptores no contienen necesariamente los datos a los que hacen referencia.
2.2. Resolución de referencias
Las tablas utilizan dos mecanismos distintos: índices para relacionar registros (por ejemplo, una malla con su vertex buffer, index buffer y material) y offsets para localizar datos binarios. No deben mezclarse las bases de direccionamiento: los offsets de tablas pertenecen al bloque decodificado, mientras que los offsets de los datos de vértices, índices y texturas se interpretan respecto al comienzo de bulk.
Código:
tableAddress = decodedBase + offsets[tableIndex]
bulkAddress  = decodedBase + 120 + metadataSize
dataAddress = bulkAddress + dataOffset3. Cabecera del modelo decodificado
El bloque decodificado comienza con una cabecera fija de 120 bytes (0x78). Esta cabecera indica cuánto espacio ocupan los metadatos y el bulk, además de proporcionar los recuentos y offsets de las tablas. Los enteros se presentan aquí con los tipos utilizados por el parser; no se atribuye significado adicional a los campos que todavía no se han identificado.
Código:
| Offset | Campo | Tipo | Uso |
|---|---|---|---|
| +0x00 | magic | u32 | 0x000078C5 |
| +0x04 | metadataSize | u32 | Tamaño del área de metadatos posterior a cabecera |
| +0x08 | bulkSize | u32 | Tamaño de datos binarios |
| +0x0C | counts[16] | u16 × 16 | Recuento de registros por tabla |
| +0x2C | offsets[19] | u32 × 19 | Posiciones de tablas |La longitud del archivo decodificado debe coincidir exactamente con la suma de las tres regiones. Esta igualdad es una comprobación estructural fundamental: evita aceptar datos truncados o interpretar bytes de una sección como si pertenecieran a otra.
Código:
headerSize = 120
bulkStart = headerSize + metadataSize
expectedLength = headerSize + metadataSize + bulkSize
expectedLength == decodedLengthLa tabla de cadenas empieza en offsets[14] y su longitud se obtiene de counts[14]. Según la invariante indicada por el parser, esta tabla termina exactamente donde comienza bulk.
Código:
stringsStart = offsets[14]
stringsSize = counts[14]
stringsStart + stringsSize == bulkStart3.3. Recuentos y offsets
counts contiene 16 entradas de 16 bits, mientras que offsets contiene 19 entradas de 32 bits. No todas las entradas representan necesariamente tablas de registros del mismo tipo. El parser debe utilizar el stride específico de cada tabla conocida y comprobar que count * stride cabe en el intervalo de metadatos permitido. Las entradas sin semántica demostrada no deben recibir nombres inventados.
4. Tablas de metadatos
Tras la cabecera se encuentran los descriptores que organizan los recursos del modelo. Cada tabla tiene un recuento y, cuando su formato está identificado, un tamaño fijo por registro (stride). Estos registros sirven para localizar los datos reales o enlazar unos elementos con otros.
Código:
| Índice | Stride | Interpretación del parser |
|---|---:|---|
| 0 | 8 | Registros auxiliares (campos aún no totalmente interpretados) |
| 1 | 28 | Descriptores de textura |
| 2 | 52 | Materiales |
| 3 | 56 | Registros asociados a la estructura de modelo |
| 4 | 20 | Descriptores de vertex buffer |
| 5 | 12 | Descriptores de index buffer |
| 6 | 40 | Mallas y sus referencias |
| 7 | 16 | Tabla auxiliar |
| 8 | 12 | Tabla auxiliar |
| 9 | — | No admitida si contiene registros |
| 10 | 24 | Tabla auxiliar |
| 11 | 32 | Tabla auxiliar |
| 12 | 12 | Tabla auxiliar |
| 13 | — | No admitida si contiene registros |Para una tabla de stride conocido, el registro N se localiza a partir de su offset de tabla y su índice. El tamaño total ocupado se calcula multiplicando el número de registros por su stride.
Código:
recordAddress = decodedBase + offsets[tableIndex] + N * stride
tableBytes = counts[tableIndex] * stride
0 <= N < counts[tableIndex]4.2. Relación entre las tablas principales
Los descriptores de textura identifican recursos de imagen; los materiales determinan su uso en el render; los vertex buffers contienen atributos de vértice; los index buffers definen qué vértices forman cada triángulo; y los registros de malla vinculan estas piezas por índice. Por ello, el orden correcto es interpretar primero las tablas de recursos y después construir cada malla a partir de sus referencias.
4.3. Tablas todavía no identificadas
Las tablas auxiliares se conservan como datos crudos cuando su estructura o finalidad no está suficientemente demostrada. En particular, no debe asumirse que las tablas 7 y 8 de este bloque son equivalentes a cualquier tabla de tracks o secuencias usada en otro decodificador sin comprobar su contexto.
Nota: Las tablas con semántica incompleta se conservan como datos crudos. No debe atribuirse un significado no demostrado a sus campos.
5. Vertex buffers
Los vertex buffers almacenan los atributos de los vértices en la región bulk. Sus descriptores están en la tabla 4 y tienen un tamaño fijo de 0x14 bytes. Cada descriptor indica dónde comienza el bloque, cuántos vértices contiene, cuánto ocupa cada vértice y qué distribución de atributos utiliza.
Código:
| Offset | Campo | Tipo | Uso |
|---|---|---|---|
| +0x00 | dataOffset | u32 | Desplazamiento desde el inicio de bulk |
| +0x08 | count | u16 | Número de vértices |
| +0x0A | stride | u8 | Tamaño de cada vértice en bytes |El parser no admite una única estructura universal de vértice. El stride debe corresponder al identificador de layout esperado; esta pareja es la que determina cómo interpretar los bytes del registro.
Código:
| Stride | Layout | Tamaño por vértice |
|---|---|---|
| 28 | 0x00264420 | 0x1C |
| 40 | 0x26442120 | 0x28 |
| 20 | 0x00754420 | 0x14 |5.2. Direccionamiento y lectura
Una vez elegido el layout, los vértices se leen secuencialmente a partir de bulk + dataOffset. El tamaño total del buffer es count * stride.
Código:
vertexBufferStart = bulkStart + dataOffset
vertexAddress(i) = vertexBufferStart + i * stride
vertexBufferBytes = count * stride
0 <= i < count5.3. Coordenadas UV
La posición del atributo UV depende del tamaño del registro. Para el layout de 40 bytes, el offset es +0x18; para los otros layouts admitidos, es +0x0C.
Código:
uvOffset = (stride == 40) ? 0x18 : 0x0C
uvAddress(i) = vertexAddress(i) + uvOffset6. Index buffers y triángulos
Los index buffers definen la conectividad de la geometría: en lugar de repetir las coordenadas de cada vértice por triángulo, almacenan índices que apuntan a las entradas de un vertex buffer. Sus descriptores pertenecen a la tabla 5 y ocupan 0x0C bytes.
Código:
| Offset | Campo | Tipo | Uso |
|---|---|---|---|
| +0x00 | dataOffset | u32 | Desplazamiento desde el inicio de bulk |
| +0x08 | indexCount | u16 | Número total de índices |
| +0x0A | indexSize | u16 | Debe valer 2: índices de 16 bits |Los índices se almacenan en bulk, a partir de dataOffset. El valor 2 del campo indexSize indica que cada índice ocupa dos bytes. Por tanto, el tamaño del bloque es indexCount * 2.
Código:
indexBufferStart = bulkStart + dataOffset
indexAddress(i) = indexBufferStart + i * 2
indexBufferBytes = indexCount * 26.2. Formación de triángulos
La estructura documentada representa triángulos mediante grupos consecutivos de tres índices. Por eso indexCount debe ser múltiplo de tres.
Código:
indexCount % 3 == 0
triangleCount = indexCount / 3

triangle(i) = (
    indices[i * 3 + 0],
    indices[i * 3 + 1],
    indices[i * 3 + 2]
)7. Meshes
La tabla 6 contiene los registros de malla. Cada registro ocupa 0x28 bytes y relaciona un material, un vertex buffer y un index buffer. Esto significa que la malla no necesita incluir los vértices y triángulos dentro de su propio descriptor: utiliza referencias a los recursos ya descritos en otras tablas.
Código:
| Offset | Tipo | Interpretación |
|---|---|---|
| +0x00 | u8 | Material index |
| +0x02 | u16 | Vertex buffer index |
| +0x04 | u16 | Index buffer index |
| +0x08 | u16 | Triangle count |
| +0x10..+0x18 | float × 3 | Bounds mínimo XYZ |
| +0x1C..+0x24 | float × 3 | Bounds máximo XYZ |El primer paso para reconstruir una malla consiste en resolver sus tres referencias: materialIndex apunta a la tabla 2, vertexBufferIndex a la tabla 4 e indexBufferIndex a la tabla 5. Cada índice debe estar dentro del recuento de su tabla.
Código:
materialIndex < counts[2]
vertexBufferIndex < counts[4]
indexBufferIndex < counts[5]7.2. Comprobación del número de triángulos
El registro de malla incluye triangleCount, que debe coincidir con el número de triángulos obtenido del index buffer asociado. Esta comprobación detecta referencias equivocadas o una lectura incorrecta de los descriptores.
Código:
triangleCount * 3 == indexCountLos seis floats situados entre +0x10 y +0x24 representan los límites mínimo y máximo de la malla en los ejes X, Y y Z. Sirven como referencia espacial para validar la geometría reconstruida y describir la extensión del objeto.
Código:
boundsMin = (minX, minY, minZ)
boundsMax = (maxX, maxY, maxZ)

minX <= maxX
minY <= maxY
minZ <= maxZ7.4. Construcción final
Una vez resueltas las referencias, el exportador puede construir el objeto Mesh de Unity: carga los atributos de los vértices, asigna los índices de triángulos, aplica el material correspondiente y lo incorpora a la jerarquía del modelo. El esqueleto y los clips se añaden mediante su pipeline independiente.
Código:
Mesh record
  +-- materialIndex ------> Material
  +-- vertexBufferIndex --> Vertex buffer --> vertices / UV / atributos
  +-- indexBufferIndex ---> Index buffer  --> triángulos
+-- boundsMin/Max ------> límites geométricos8. Esqueleto y animación
El sistema de animaciones de Pokémon Pokédex 3D Pro utiliza una representación basada en tracks independientes asociados a los nodos del esqueleto. En lugar de almacenar una transformación completa para cada hueso en todos los frames, cada track contiene una secuencia de keyframes con sus respectivos tiempos y valores. Durante la reproducción, el motor interpola estos valores para reconstruir las transformaciones intermedias.
La información de animación se encuentra separada de los buffers geométricos. El parser utiliza la tabla 7 para localizar los tracks y la tabla 8 para identificar las secuencias de animación.
8.1. Descriptores de tracks
Cada descriptor de track ocupa 0x10 bytes y contiene:
Código:
| Offset | Campo | Tipo | Uso |
|---|---|---|---|
| +0x00 | dataOffset | u32 | Offset de los keyframes |
| +0x04 | targetIndex | u16 | Índice del hueso |
| +0x06 | targetName | u16 | Offset del nombre en la tabla de strings |
| +0x08 | lastFrame | u16 | Último frame del track |
| +0x0A | keyCount | u16 | Número de keyframes |
| +0x0C | channel | u16 | Tipo de transformación |
| +0x0E | dimensions | u16 | Componentes por keyframe |
Código:
0x71 + 4 componentes = Rotación (Quaternion)
0x53 + 3 componentes = Escala (Vector3)
0x54 + 3 componentes = Traslación (Vector3)8.2. Formato de los keyframes
Los keyframes utilizan dos estructuras diferentes dependiendo del canal.
Para rotaciones, cada registro ocupa 0x0A bytes:
Código:
| Offset | Campo | Tipo | Uso |
|---|---|---|---|
| +0x00 | frame | u16 | Frame de la key |
| +0x02 | x | u16 | Componente X |
| +0x04 | y | u16 | Componente Y |
| +0x06 | z | u16 | Componente Z |
| +0x08 | w | u16 | Componente W |
Código:
component = (encodedValue - 32767) / 32768.0Para traslación y escala, cada registro ocupa 0x10 bytes:
Código:
| Offset | Campo | Tipo | Uso |
|---|---|---|---|
| +0x00 | frame | float | Posición temporal |
| +0x04 | x | float | Componente X |
| +0x08 | y | float | Componente Y |
| +0x0C | z | float | Componente Z |8.3. Reconstrucción de los frames
Una vez decodificadas las keys, el sistema puede calcular la transformación de cualquier frame de la animación. Primero se localizan las dos keys que rodean el frame solicitado. Para ello se utiliza una búsqueda binaria sobre los tiempos almacenados.
El factor de interpolación se calcula como:
Código:
t = (frame - frameA) / (frameB - frameA)
Código:
value = A + (B - A) * t8.4. Secuencias de animación
La tabla 8 contiene las secuencias que agrupan los frames en animaciones individuales. Cada descriptor ocupa 0x0C bytes:
Código:
| Offset | Campo | Tipo | Uso |
|---|---|---|---|
| +0x00 | nameOffset | u32 | Nombre de la animación |
| +0x04 | firstFrame | u16 | Primer frame |
| +0x06 | lastFrame | u16 | Último frame |
| +0x08 | flags | u32 | Bit 0: animación en loop |
Código:
frameCount = lastFrame - firstFrame + 18.5. Conversión a Unity
El exportador reconstruye las animaciones a 60 FPS. Para cada secuencia genera curvas independientes de posición, rotación o escala y las asigna al Transform correspondiente mediante la ruta jerárquica del hueso. El tiempo de cada key exportada se calcula como:
Código:
time = (frame - firstFrame) / 60.0El resultado es una colección de AnimationClips que reproducen las transformaciones del esqueleto a partir de los datos originales del juego, sin necesidad de almacenar manualmente una pose completa para cada frame en el formato nativo. Con este procedimiento podemos reconstruir las secuencias óseas reconocidas por el parser. Quedan fuera de esta descripción los canales todavía no identificados y cualquier comportamiento adicional de animación que no esté representado en los tracks soportados.
9. Resultados
Como una imagen vale más que mil palabras, aquí está el resultado de toda esta investigación:
10. Front-end
Al utilizar Unity Engine como Front-End para hacer ingeniería inversa, obtenemos una forma directa y completamente user-friendly de importar modelos para Fangames.
Última edición: